การทดสอบช่วยปรับปรุงการเรียนรู้ใหม่หรือไม่เพราะเป็นการป้องกันการแทรกแซงเชิงรุก?(1)
Jun 07, 2023
เนื่องจาก PI เป็นกลางในทางทฤษฎี บัญชี release-fromPI นี้จึงปล่อยให้กลไกของผู้สมัครเปิดอยู่ซึ่งการทดสอบแบบสอดแทรกจะช่วยปรับปรุงการเรียนรู้ใหม่ PI สามารถลดการเรียนรู้ที่ตามมาผ่านกระบวนการที่ทำงานทั้งที่ดึงข้อมูลหรือเข้ารหัส ในเอกสารนี้ เราเน้นที่คำอธิบายตามการดึงข้อมูลของ PI สำหรับผลการทดสอบไปข้างหน้า Szpunar และคณะ (2008) กำหนดให้ผลการทดสอบไปข้างหน้าเป็นการปรับปรุงการเลือกปฏิบัติในรายการ - แนวคิดคือการทดสอบช่วยเพิ่มการคงอยู่ของรายการที่ทดสอบ ซึ่งทำให้ผู้เข้าร่วมสามารถแยกแยะการเป็นสมาชิกรายการของรายการที่ศึกษาได้ดีขึ้นและเพื่อหลีกเลี่ยงการบุกรุก (ดูเพิ่มเติมที่ Chan & McDermott, 2007; Jang & Huber, 2008; Postman et al., 1968; Postman & Keppel, 1977) – ด้วยเหตุนี้ แนวคิดดั้งเดิมของบัญชี release-from-PI จึงมุ่งเน้นไปที่กระบวนการดึงข้อมูล และเราก็ทำเช่นเดียวกันที่นี่
ผลของ Cistanche- ปรับปรุงหน่วยความจำ
คลิกที่นี่เพื่อดูผลิตภัณฑ์ Cistanche Improve Memory
【สอบถามเพิ่มเติม】 อีเมล:cindy.xue@wecistanche.com / Whats App: 0086 18599088692 / Wechat: 18599088692
เชิงนามธรรม
การทำแบบทดสอบเนื้อหาที่เรียนไปแล้วสามารถปรับปรุงการเรียนรู้ใหม่ได้ คำอธิบายประการหนึ่งสำหรับผลการทดสอบล่วงหน้านี้คือการดึงข้อมูลผู้เรียนจากการแทรกแซงเชิงรุก (PI) แม้ว่าบัญชี release-from-PI นี้ได้รับการสนับสนุนเชิงประจักษ์จำนวนมาก แต่หลักฐานที่มีอยู่ส่วนใหญ่มีความสัมพันธ์กันมากกว่าเชิงสาเหตุ เราทดสอบบัญชีนี้โดยจัดการระดับของ PI ที่ผู้เข้าร่วมประสบขณะที่พวกเขาศึกษารายการต่างๆ ในขณะที่รับการทดสอบที่สอดแทรกหรือไม่ ในการทดลองที่ 1 และ 2 เราพบว่าการทดสอบให้ประโยชน์ต่อการเรียนรู้ใหม่เช่นเดียวกัน โดยไม่คำนึงถึงระดับ PI ผลลัพธ์เหล่านี้ขัดแย้งกับผลลัพธ์จาก Nunes และ Weinstein (Memory, 20(2), 138–154, 2012) ซึ่งพบว่าไม่มีผลการทดสอบล่วงหน้าเมื่อเงื่อนไขการเข้ารหัสลด PI ให้เหลือน้อยที่สุด ในการทดลองที่ 3 และ 4 เราล้มเหลวในการทำซ้ำผลลัพธ์ ข้อมูลของเราร่วมกันบ่งชี้ว่า PI ที่ลดลงอาจเป็นผลพลอยได้ แทนที่จะเป็นปัจจัยเชิงสาเหตุของผลการทดสอบล่วงหน้า
ประโยชน์ของ cistanche tubulosa-ปรับปรุงหน่วยความจำ
คำหลัก
การฝึกดึง · การเรียนรู้ใหม่ · ส่งต่อผลการทดสอบ · การแทรกแซงเชิงรุก
การแนะนำ
นักเรียนและครูหลายคนถือว่าการทดสอบเป็นเครื่องมือในการประเมิน (Bonner, 2009; Karpicke et al., 2009) อย่างไรก็ตาม งานวิจัยจำนวนมากระบุว่าการทำแบบทดสอบช่วยเพิ่มการเรียนรู้ (Chan, Meissner, et al., 2018; Karpicke & Roediger, 2008; Rowland, 2014; สำหรับข้อยกเว้น โปรดดูที่ Chan et al., 2017; Davis & Chan, 2015; Finn & Roediger, 2013) ประโยชน์ของการทดสอบสามารถจำแนกได้สองวิธี ในแง่หนึ่ง การทดสอบส่งเสริมการเรียนรู้เนื้อหาที่ผ่านการทดสอบ ซึ่งบางครั้งเรียกว่าผลการทดสอบย้อนหลัง ในทางกลับกัน การทดสอบเนื้อหาที่ศึกษาก่อนหน้านี้ช่วยปรับปรุงการเรียนรู้เนื้อหาใหม่ในภายหลัง ซึ่งบางครั้งเรียกว่าผลการทดสอบล่วงหน้า ผลกระทบหลังนี้เป็นจุดสนใจของการศึกษาในปัจจุบัน
ผลการทดสอบไปข้างหน้ามักถูกตรวจสอบโดยใช้การเรียนรู้แบบหลายรายการ กระบวนทัศน์การทดสอบแบบสอดแทรก ในช่วงเริ่มต้นของการศึกษา ผู้เข้าร่วมจะได้รับแจ้งว่าพวกเขาอาจทำแบบทดสอบหรือไม่ก็ได้หลังจากศึกษาแต่ละรายการ แต่ในความเป็นจริง ผู้เข้าร่วมในเงื่อนไขการทดสอบมักจะทำการทดสอบหลังจากแต่ละรายการ ในขณะที่ผู้ที่อยู่ในเงื่อนไขการควบคุมอาจศึกษารายการใหม่อีกครั้งหรือทำงานเสริม เช่น การแก้ปัญหาทางคณิตศาสตร์ ผู้เข้าร่วมทั้งหมดได้รับการทดสอบในรายการเป้าหมายขั้นสุดท้าย (รูปที่ 1 แสดงการออกแบบการทดลองของเรา แต่พวกเขายังสอดคล้องกับการออกแบบตามบัญญัติที่ใช้ในวรรณกรรม) หากผู้เข้าร่วมการทดสอบทำงานได้ดีกว่าการทดสอบเป้าหมายมากกว่าผู้เข้าร่วมการควบคุม การทดสอบแบบสอดแทรกจะช่วยอำนวยความสะดวกในการเรียนรู้ใหม่ (เช่น ผลการทดสอบล่วงหน้า) ผลการทดสอบไปข้างหน้านั้นแข็งแกร่งและได้รับการปฏิบัติตามเงื่อนไขต่างๆ (สำหรับการตรวจสอบ โปรดดูที่ Chan, Manley, et al., 2018)

cistanche ทำอะไร - ปรับปรุงหน่วยความจำ
แม้ว่าจะมีวรรณกรรมมากมายเกี่ยวกับผลการทดสอบล่วงหน้า แต่การศึกษาส่วนใหญ่เน้นเชิงประจักษ์ (cf. Chan et al., 2020; Chan, Manley, et al., 2018; Kliegl & Bäuml, 2021) เมื่อเร็ว ๆ นี้ นักวิจัยได้เริ่มสำรวจกลไกที่เป็นรากฐานของผลกระทบ (สำหรับการทบทวน โปรดดูที่ Chan, Meissner, et al., 2018; Pastötter & Bäuml, 2014; Yang et al., 2018) แต่จำนวนการศึกษาเชิงประจักษ์กลับแซงหน้าไปมาก ของพวกทฤษฏี. ดังนั้น เป้าหมายของการศึกษาในปัจจุบันคือการขยายความเข้าใจทางทฤษฎีของผลการทดสอบล่วงหน้า โดยเฉพาะอย่างยิ่ง เราได้จัดเตรียมการทดสอบที่สำคัญของการปลดปล่อยจากคำอธิบายการแทรกแซงเชิงรุก (Szpunar et al., 2008; Yang et al., 2018) ซึ่งแสดงให้เห็นว่าการทดสอบการแทรกแซงช่วยอำนวยความสะดวกในการเรียนรู้ในภายหลัง เนื่องจากเป็นฉนวนป้องกันผู้เข้าร่วมจากการก่อตัวของการรบกวนเชิงรุก (PI ) จากการเรียนรู้ก่อนหน้า ด้านล่างนี้ เราจะทบทวนวรรณกรรมที่เกี่ยวข้องและอธิบายถึงแรงจูงใจในการศึกษาของเรา

รูปที่ 1 ออกแบบสำหรับสี่การทดลอง S=การศึกษา, M=คณิตศาสตร์, T=การทดสอบ ตัวห้อยระบุโครงสร้างรายการ (ML=รายการผสม, BL=รายการที่ถูกบล็อก) ในรายการแบบผสม มีการนำเสนอคำจากหลายประเภท ในรายการที่ถูกบล็อก มีการนำเสนอคำจากหมวดหมู่เดียว ตัวเลขในตัวห้อยระบุหมายเลขรายการ (เช่น L1=รายการ 1, L2=รายการ 2)
การรบกวนเชิงรุกและผลการทดสอบไปข้างหน้า
การรบกวนเชิงรุกมีบทบาทสำคัญในการเรียนรู้ของนักเรียน สมมติว่านักเรียนบางคนเรียนหลักสูตรภาษาสเปนและภาษาฝรั่งเศสในวันเดียวกัน ในชั้นเรียนภาษาสเปน พวกเขาได้เรียนรู้ว่าคำว่า อามอร์ แปลว่าความรัก ไม่กี่ชั่วโมงต่อมา ในชั้นเรียนภาษาฝรั่งเศส พวกเขาได้เรียนรู้ว่า amour (ที่มีตัว "u") หมายถึงความรัก ต่อมา หากให้นักเรียนเขียนคำว่ารักเป็นภาษาฝรั่งเศส พวกเขาอาจจำคำว่า amor แทน amor ตัวอย่างนี้แสดงสถานการณ์หนึ่งที่การเรียนรู้ก่อนหน้า (ภาษาสเปน) รบกวนการเรียนรู้ใหม่ (ภาษาฝรั่งเศส) เช่น การแทรกแซงเชิงรุก (PI)
PI ได้รับการพิจารณาอย่างกว้างขวางว่าเป็นแหล่งสำคัญของการลืม (สำหรับบทวิจารณ์ โปรดดูที่ Crowder, 1976; Kliegl & Bäuml, 2021) ในการสาธิตครั้งแรกสุดของผลการทดสอบไปข้างหน้า Tulving และ Watkins (1974) ถือว่าฉนวนของ PI เป็นปัจจัยเชิงสาเหตุของผลกระทบ ในการศึกษาของพวกเขา ผู้เข้าร่วมศึกษาสองรายการ (รายการแรกที่มีการเชื่อมโยง AB และรายการที่สองที่มีการเชื่อมโยง AC) จากนั้นจึงพยายามจำคำศัพท์จากทั้งสองรายการในการทดสอบการเรียกคืนฟรีแบบดัดแปลงแก้ไข (MMFR) การจัดการที่สำคัญคือผู้เข้าร่วมได้รับการทดสอบในรายการ AB รายการแรกก่อนที่พวกเขาเรียนรู้รายการ AC รายการที่สองหรือไม่ (เช่น การมีหรือไม่มีการทดสอบแบบสอดแทรก) และผลลัพธ์ของพวกเขาแสดงให้เห็นว่าการทดสอบในทันทีของรายการ 1 ช่วยเพิ่มการเรียกคืนรายการ 2 อย่างมาก Tulving และ Watkins ตีความการค้นพบนี้ว่า "การแก้ไขของกิจกรรมที่ต้องการการเรียกข้อมูลที่เก็บไว้อย่างชัดเจนดูเหมือนจะป้องกันรายการ AB ออกจากรายการ AC ในลักษณะที่ลบรายการเดิมที่เป็นองค์ประกอบรบกวนในการเรียนรู้ของรายการหลัง" (น.192).
การแข่งขันการตอบสนองเป็นกลไกที่ PI บั่นทอนการเรียนรู้ที่ตามมา โดยเฉพาะอย่างยิ่ง เมื่อเปรียบเทียบกับสถานการณ์ที่ผู้เข้าร่วมเรียนรู้เฉพาะรายการเป้าหมาย การเรียนรู้ก่อนหน้าจะเพิ่มจำนวนผู้สมัครรับข้อมูลสำหรับคิวที่กำหนด และรายการเหล่านี้จะแข่งขันกันเองและรบกวนการเรียกคืนรายการเป้าหมาย วิธีที่ได้รับการยอมรับอย่างกว้างขวางในการวัดระดับการแข่งขันด้านการตอบสนองและ PI คือผ่านการบุกรุกของรายการจากรายการที่ไม่ใช่เป้าหมายในระหว่างการทดสอบการเรียกคืน (Bäuml & Kliegl, 2013; Chan, Meissner, et al., 2018; Crowder, 1976; Darley & Murdock, 1971; Pierce et al., 2017; Postman & Hasher, 1972; Underwood, 1975; Yang et al., 2018; Zaromb & Roediger, 2010)
การทดลอง Cistanche Deserticola
เป็นหลักฐานว่าการทดสอบแบบสอดแทรกส่งเสริมการเรียนรู้ใหม่โดยการปลูกฝังให้ผู้เรียนต่อต้านอิทธิพลของ PI การศึกษาจำนวนมากแสดงให้เห็นว่าการทดสอบแบบสอดแทรกสามารถลดการก้าวก่ายจากการเรียนรู้ก่อนหน้าได้ ตัวอย่างเช่น Darley และ Murdock (1971) พบว่าผู้เรียนมีโอกาสน้อยที่จะบุกรุกสิ่งที่เคยทดสอบมาก่อนมากกว่าสิ่งที่ไม่ได้ทดสอบก่อนหน้านี้ ในการศึกษาของพวกเขา ผู้เข้าร่วมศึกษาคำศัพท์สิบรายการในขณะที่คาดหวังการทดสอบสะสม หลังจากศึกษาแต่ละรายการ ผู้เข้าร่วมทำแบบทดสอบการเรียกคืนทันทีสำหรับครึ่งหนึ่งของรายการ และนับไปข้างหน้าสามรายการสำหรับรายการอื่นๆ เมื่อตรวจสอบความถี่ของการบุกรุกรายการก่อนหน้าระหว่างการทดสอบการเรียกคืนในทันที ดาร์ลีย์และเมอร์ด็อคพบว่าการบุกรุกส่วนใหญ่ (เช่น ร้อยละ 81) เป็นของรายการที่ไม่ได้ทดสอบ ซึ่งแสดงให้เห็นว่ารายการที่ทดสอบอาจอ่อนแอต่อการแข่งขันตอบโต้น้อยกว่า รายการที่ไม่ได้ทดสอบ เงินทุนนี้สามารถตีความได้ว่าเป็นหลักฐานสำหรับข้อได้เปรียบในการเลือกล่วงหน้า (กล่าวคือ รายการที่ทดสอบมีโอกาสน้อยที่จะนึกถึงเมื่อผู้เข้าร่วมพยายามที่จะเรียกคืนรายการที่เพิ่งศึกษาและยังไม่ได้ทดสอบ) หรือข้อได้เปรียบในการแก้ไขล่าช้า (กล่าวคือ ผู้เข้าร่วมสามารถพร้อม ระงับรายการที่เรียกคืนหากพวกเขาจำได้ว่ารายการนั้นถูกเรียกคืน) ไม่ว่าจะด้วยวิธีใด ความเป็นไปได้ทั้งสองประการชี้ให้เห็นว่าประโยชน์ของการทดสอบอาจเกิดจากการลดลงของ PI
ปลดออกจากบัญชี PI
ในการศึกษาที่ฟื้นความสนใจในปรากฏการณ์ของผลการทดสอบไปข้างหน้า Szpunar et al. (2008) แสดงให้เห็นว่าหลังจากศึกษารายการคำที่เกี่ยวข้องกัน 5 รายการ ผู้เข้าร่วมที่ได้รับการทดสอบในรายการ 1–4 มีการบุกรุกระหว่างการเรียกคืนรายการ 5 น้อยกว่าผู้เข้าร่วมที่ไม่ได้ทดสอบในรายการ 1–4 ยิ่งไปกว่านั้น ผู้เข้าร่วมการทดสอบจำรายการ 5 รายการได้มากกว่าผู้เข้าร่วมการควบคุม จากผลลัพธ์เหล่านี้ Szpunar และเพื่อนร่วมงานได้เสนอบัญชี release-fromPI ซึ่งเป็นการทดสอบผู้เข้าร่วมที่ได้รับการฉีดวัคซีนต่อต้านการสะสมของ PI และนี่ก็เป็นความรับผิดชอบต่อผลประโยชน์การเรียนรู้ของรายการที่ 5 ในหมู่ผู้เข้าร่วมการทดสอบ การศึกษาอื่น ๆ ยังรายงานการค้นพบที่คล้ายกันว่าการทดสอบเป็นระยะ ๆ ลดการบุกรุกและเพิ่มการเรียนรู้ใหม่ ๆ (Chan, Manley, et al., 2018; Weinstein et al., 2011, 2014; Yang et al., 2018)
เนื่องจาก PI เป็นกลางในทางทฤษฎี บัญชี release-fromPI นี้จึงปล่อยให้กลไกของผู้สมัครเปิดอยู่ซึ่งการทดสอบแบบสอดแทรกจะช่วยปรับปรุงการเรียนรู้ใหม่ PI สามารถลดการเรียนรู้ที่ตามมาผ่านกระบวนการที่ทำงานทั้งที่ดึงข้อมูลหรือเข้ารหัส ในเอกสารนี้ เราเน้นที่คำอธิบายตามการดึงข้อมูลของ PI สำหรับผลการทดสอบไปข้างหน้า Szpunar และคณะ (2008) กำหนดให้ผลการทดสอบไปข้างหน้าเป็นการปรับปรุงการเลือกปฏิบัติในรายการ - แนวคิดคือการทดสอบช่วยเพิ่มการคงอยู่ของรายการที่ทดสอบ ซึ่งทำให้ผู้เข้าร่วมสามารถแยกแยะการเป็นสมาชิกรายการของรายการที่ศึกษาได้ดีขึ้นและเพื่อหลีกเลี่ยงการบุกรุก (ดูเพิ่มเติมที่ Chan & McDermott, 2007; Jang & Huber, 2008; Postman et al., 1968; Postman & Keppel, 1977) – ด้วยเหตุนี้ แนวคิดดั้งเดิมของบัญชี release-from-PI จึงมุ่งเน้นไปที่กระบวนการดึงข้อมูล และเราก็ทำเช่นเดียวกันที่นี่
หากการทดสอบแบบสอดแทรกช่วยเสริมการเรียนรู้ใหม่เนื่องจากลด PI ดังนั้น ประโยชน์จากการทดสอบล่วงหน้าสำหรับการเรียกคืนที่ถูกต้องควรมาพร้อมกับการลดการบุกรุก สอดคล้องกับแนวคิดนี้ ในการวิเคราะห์อภิมานเมื่อเร็วๆ นี้ (Chan, Meissner, et al., 2018) จากการศึกษา 38 เรื่องที่สังเกตผลการทดสอบล่วงหน้าและรายงานการบุกรุก พบว่า 36 การทดสอบแบบสอดแทรกลดการบุกรุก ทำให้ ให้น้ำหนักกับบัญชี release-from-PI อย่างไรก็ตาม เหตุผลนี้ขึ้นอยู่กับความสัมพันธ์ (อันที่จริง จากการศึกษาต่างๆ มีความสัมพันธ์ที่ชัดเจนระหว่างขนาดของผลการทดสอบล่วงหน้าในการเรียกคืนที่ถูกต้องและการบุกรุกในข้อมูลของ Chan และคณะ r=-.60 , p < .001) และมีงานวิจัยเพียงไม่กี่ชิ้นที่ให้การทดสอบบัญชี release-fromPI โดยตรง โดยเฉพาะอย่างยิ่ง หากการทดสอบแบบสอดแทรกทำให้เกิดการเรียนรู้ใหม่โดยการลดอิทธิพลของ PI ขนาดของผลการทดสอบไปข้างหน้าควรขึ้นอยู่กับระดับของ PI ที่ผู้เรียนได้รับประสบการณ์ นั่นคือ ประโยชน์ของการทดสอบควรจะชัดเจนมากขึ้นเมื่อผู้เรียนถูกคาดหวังให้ สัมผัสกับ PI ที่ดียิ่งขึ้น
Szpunar และคณะ (2008) จัดทำการทดสอบโดยตรงของบัญชี release-from-PI ในการทดลองที่ 2 โดยเฉพาะอย่างยิ่ง พวกเขาจัดการ PI โดยการเปลี่ยนแปลงจำนวนของรายการที่ไม่ได้ทดสอบ ซึ่งผู้เข้าร่วมต้องศึกษาก่อนรายการเป้าหมาย (ดูรูปที่ S1 ของออนไลน์ วัสดุเสริม (OSM) ที่ https://osf.io/wghbc/ สำหรับการออกแบบ) และ PI ได้รับการออกแบบให้สร้างขึ้นจากรายการต่างๆ ผู้เข้าร่วมในเงื่อนไขการทดสอบทุกรายการควรไวต่อผลกระทบด้านลบของ PI น้อยกว่า ในทางตรงกันข้าม กลุ่มที่อยู่ในเงื่อนไขการควบคุมได้รับการทดสอบเพียงรายการเดียวในรายการที่ 2-5 (เช่น กลุ่มหนึ่งได้รับการทดสอบเฉพาะรายการที่ 2 กลุ่มหนึ่งในรายการที่ 3 เป็นต้น) และระดับของ PI คาดว่าจะ เป็นสัดส่วนกับจำนวนรายการที่ไม่ได้ทดสอบก่อนการทดสอบ สอดคล้องกับสมมติฐานที่ว่าการทดสอบก่อนหน้าจะลดการสะสมของ PI เมื่อเปรียบเทียบจำนวนการบุกรุกที่เกิดจากผู้เข้าร่วมในเงื่อนไขการควบคุมกับผู้เข้าร่วมในเงื่อนไขการทดสอบทุกรายการ Szpunar et al. พบว่าการบุกรุกเพิ่มขึ้นเมื่อจำนวนรายการที่ไม่ได้ทดสอบเพิ่มขึ้น และการบุกรุกที่เพิ่มขึ้นนี้มาพร้อมกับผลการทดสอบล่วงหน้าที่เพิ่มขึ้นสำหรับการเรียกคืนที่ถูกต้อง
แม้ว่าผลลัพธ์ของ Szpunar et al. (2008) จะสนับสนุนบัญชี release-from-PI แต่การจัดการกับระดับของ PI ตามจำนวนรายการการศึกษาทำให้เกิดปัญหาการตีความเนื่องจากการดัดแปลง PI นี้ถูกรบกวนด้วยความถี่ในการทดสอบ เมื่อเปรียบเทียบผู้เข้าร่วมในเงื่อนไขการทดสอบทุกรายการกับผู้เข้าร่วมในเงื่อนไขการควบคุม ประโยชน์ของการทดสอบแบบสอดแทรกมีมากกว่าเมื่อผู้เข้าร่วมในเงื่อนไขการควบคุมได้ศึกษารายการที่ไม่ได้ทดสอบมากขึ้น การตีความข้อค้นพบประการหนึ่งคือการทดสอบแบบสอดแทรกช่วยลดอิทธิพลของการแข่งขันด้านการตอบสนองระหว่างการเรียกคืน ซึ่งนำไปสู่ผลการทดสอบล่วงหน้า อย่างไรก็ตาม คำอธิบายอื่น ๆ ก็ใช้ได้เหมือนกัน ตัวอย่างเช่น การจัดกลุ่มความหมายในการเรียกคืน ซึ่งทำหน้าที่เป็นตัวบ่งชี้ถึงการจัดระเบียบหน่วยความจำ จะเพิ่มขึ้นตามความถี่ในการทดสอบ (Chan et al., 2020; Zaromb & Roediger, 2010) และโดยทั่วไปแล้วเงินทุนนี้มาจากการปรับกลยุทธ์ให้เหมาะสม นอกจากนี้ การเพิ่มจำนวนของการทดสอบแบบสอดแทรกสามารถส่งเสริมการเข้ารหัสที่เอาใจใส่ เนื่องจากสัญญาณการทดสอบที่เกิดขึ้นบ่อยครั้งกับผู้เข้าร่วมว่าพวกเขาน่าจะได้รับการทดสอบอีกครั้งในไม่ช้า ซึ่งทำให้ผู้เข้าร่วมได้รับความคาดหวังในการทดสอบที่เพิ่มขึ้น สิ่งสำคัญคือบัญชีทั้งสองนี้ไม่ต้องการการเผยแพร่จาก PI เป็นกลไกอธิบาย ในการทบทวนวรรณกรรมของเรา การศึกษาทั้งหมด (ยกเว้น Nunes & Weinstein, 2012, การศึกษาที่อธิบายไว้ด้านล่าง) ที่ให้การสนับสนุนสำหรับบัญชี release-from-PI ประสบกับปัญหาที่คล้ายคลึงกัน ดังนั้นข้อมูลที่มีอยู่ไม่ได้ให้การสนับสนุนที่ชัดเจนสำหรับการเผยแพร่ -จาก-บัญชี PI
ผงซิสแตนช์
การจัดการ PI ด้วยวิธีการเปลี่ยนแปลงเนื้อหา
ในการศึกษาปัจจุบัน เรามีเป้าหมายที่จะแยกการจัดการ PI ของเราออกจากความถี่ในการทดสอบ ด้วยเหตุนี้ เราจึงเปลี่ยน PI โดยใช้วิธีเปลี่ยนเนื้อหาในกระบวนทัศน์ของ Brown-Peterson แบบดั้งเดิม (Brown, 1958; Peterson & Peterson, 1959) โดยสังเขป PI จะถูกสะสมเมื่อผู้เข้าร่วมศึกษาชุดของรายการที่คล้ายกัน (เช่น คำจากหมวดหมู่เดียวกัน เช่น ผลไม้) แต่เมื่อเนื้อหาของรายการศึกษาเปลี่ยนไป (เช่น เป็นคำในหมวดหมู่อื่น เช่น สัตว์) ผู้เรียนจะได้รับการปลดปล่อยจากการรบกวนเชิงรุก เพราะพวกเขาสามารถใช้การเปลี่ยนแปลงในหมวดหมู่ความหมายเพื่อจำกัดการค้นหาหน่วยความจำระหว่างการค้นคืน (เช่น โดยพยายามดึงสัตว์เท่านั้น Wickens et al., 1963, 1981)
กระบวนทัศน์การเปลี่ยนแปลงเนื้อหามีความเหมาะสมเป็นอย่างยิ่งในการตรวจสอบการปลดออกจากบัญชี PI ด้วยเหตุผลสองประการ ประการแรก วิธีการนี้ช่วยให้เราสามารถปรับเปลี่ยนระดับของ PI ที่ผู้เข้าร่วมได้รับโดยไม่ต้องเปลี่ยนแปลงจำนวนข้อมูลที่พวกเขาต้องศึกษา ที่สำคัญกว่านั้น วิธีการเปลี่ยนเนื้อหาเป็นวิธีในการเปลี่ยนแปลง PI ในรายการที่จัดหมวดหมู่โดยไม่ต้องเปลี่ยนคำที่ผู้เข้าร่วมศึกษาข้ามเงื่อนไข นั่นคือผู้เข้าร่วมทั้งหมดศึกษาคำเดียวกัน แต่ PI ถูกจัดการผ่านลำดับการนำเสนอ ประการที่สอง เนื่องจากวัตถุประสงค์ทางทฤษฎีของเราคือการตรวจสอบว่า release-fromPI ซึ่งเป็นปรากฏการณ์ที่ยึดตามการดึงข้อมูล มีหน้าที่รับผิดชอบต่อการเกิดขึ้นของเอฟเฟกต์การทดสอบล่วงหน้าหรือไม่ มีแนวโน้มว่าการเปลี่ยนแปลงเนื้อหาได้รับการระบุเป็นขั้นตอนที่ส่งผลต่อการดึงข้อมูลโดยเฉพาะ ส่วนประกอบของเอฟเฟกต์ PI (Engle, 1975; Gardiner et al., 1972; Kliegl & Bäuml, 2021; Wixted & Rohrer, 1993)
เมื่อใช้วิธีการเปลี่ยนเนื้อหา Nunes และ Weinstein (2012) รายงานตามที่เราทราบ หลักฐานเชิงสาเหตุเพียงอย่างเดียวสำหรับบัญชีที่เผยแพร่จาก PI ในการทดลอง ผู้เข้าร่วมศึกษาคำศัพท์ของ Deese-Roediger-McDermott (DRM, Roediger & McDermott, 1995) จำนวน 5 ชุด ในการทดลองที่ 1 คำที่เป็นของธีม DRM แต่ละรายการจะกระจายไปตามรายการการศึกษา 5 รายการ โดยแต่ละรายการประกอบด้วยผู้เกี่ยวข้อง 3 คนจากธีม DRM หกรายการ ผู้เข้าร่วมการทดสอบทำการทดสอบหลังจากทุกรายการ ในขณะที่ผู้เข้าร่วมการควบคุมแก้ปัญหาทางคณิตศาสตร์หลังจากรายการที่ 1–4 และทำการทดสอบหลังจากรายการที่ 5 เท่านั้น ไม่น่าแปลกใจที่ผลการทดสอบไปข้างหน้าถูกสังเกต (ถูกต้อง=0.77 การบุกรุก=1.29).
แม้ว่าผลลัพธ์จากการทดลองที่ 1 ของ Nunes และ Weinstein (2012) จะขยายผลการทดสอบไปข้างหน้าจากรายการที่จัดหมวดหมู่แบบ cat ไปสู่รายการ DRM ที่เชื่อมโยง (Weinstein et al., 2010) การค้นพบที่สำคัญมาจากการทดลองที่ 2 ในที่นี้ คำศัพท์จากแต่ละ DRM ชุดรูปแบบอยู่ในรายการการศึกษาเดียวระหว่างรายการที่ 1 และ 4 รายการที่ห้าคล้ายกับการทดลองที่ 1 ซึ่งรวมคำสามคำจากแต่ละหัวข้อจากสี่หัวข้อ DRM ที่ศึกษา การค้นพบที่สำคัญคือผู้เข้าร่วมในเงื่อนไขการทดสอบและการควบคุมเรียกคืนคำในรายการเป้าหมายในสัดส่วนที่เท่ากันทุกประการ – ไม่มีผลการทดสอบล่วงหน้า นอกจากนี้ ผู้เข้าร่วมในเงื่อนไขทั้งสองมีการบุกรุกน้อยมาก จากข้อมูลของ Nunes และ Weinstein เมื่อแต่ละรายการมีธีม DRM เดียว การเปลี่ยนเนื้อหาความหมายในรายการจะปลดปล่อยผู้เข้าร่วมจากอิทธิพลเชิงลบของ PI หากการทดสอบแบบสอดแทรกทำให้เกิดการเรียนรู้ใหม่ เนื่องจากเป็นการปลดปล่อยผู้เรียนจาก PI และหากการสลับเนื้อหาลดการสร้าง PI ให้น้อยที่สุดในสภาวะการควบคุม ประโยชน์ของการทดสอบแบบสอดแทรกจะไม่เกี่ยวข้องและควรตัดผลการทดสอบไปข้างหน้าออกไป นี่คือสิ่งที่เกิดขึ้นในการทดลองที่ 2 ของ Nunes และ Weinstein ดังนั้นจึงให้การสนับสนุนที่แข็งแกร่งสำหรับบัญชี release-from-PI
ตามความรู้ของเรา Nunes และ Weinstein (2012) เป็นเพียงการศึกษาเดียวที่ตรวจสอบบัญชี release-from-PI โดยใช้วิธีการเปลี่ยนแปลงเนื้อหา อย่างไรก็ตาม ลักษณะเฉพาะหลายอย่างของการทดลองทำให้ยากต่อการสรุปผลที่ชัดเจน ประการแรก เนื่องจาก Nunes และ Weinstein ไม่ได้จัดการลำดับการนำเสนอในการทดลองเดียวกัน จึงจำเป็นต้องมีการเปรียบเทียบข้ามการทดลองระหว่างการทดลองที่ 1 และ 2 เพื่อพิจารณาว่าการลดลงของ PI ทำให้ผลการทดสอบไปข้างหน้าลดลงหรือไม่ ประการที่สอง ข้อสรุปหลักของการศึกษาของ Nunes และ Weinstein ขึ้นอยู่กับผลกระทบที่เป็นโมฆะ (กล่าวคือ ไม่มีผลการทดสอบไปข้างหน้า) ในการทดลองที่ 2 แต่การทดลองนั้นมีผู้เข้าร่วมเพียง 35 คนและการเปรียบเทียบที่สำคัญอยู่ระหว่างอาสาสมัคร 1 ประการสุดท้าย วัสดุที่แตกต่างกันในแต่ละกลุ่ม การทดลองที่ 1 และ 2 (เช่น แต่ละรายการประกอบด้วย 18 คำในการทดลองที่ 1 แต่มีเพียง 12 คำในการทดลองที่ 2) และ Nunes และ Weinstein ไม่ได้ทำให้คำของพวกเขาสมดุลกันในรายการการศึกษาทั้งหมด เช่น คำที่ปรากฏในรายการเป้าหมายไม่เคย ปรากฏในรายการอื่นๆ การขาดการถ่วงดุลจำกัดความสามารถทั่วไปของผลลัพธ์ – เป็นไปได้ว่าแทนที่การจัดการ Low-PI จะกำจัดผลการทดสอบไปข้างหน้าในการทดลองที่ 2 เป็นคำเฉพาะที่ปรากฏในรายการที่ 5 ซึ่งไม่คล้อยตามด้วยเหตุผลบางประการ เพื่อแสดงผลการทดสอบไปข้างหน้า แม้ว่าความเป็นไปได้นี้อาจดูห่างไกล แต่ก็สมควรได้รับความสนใจเนื่องจากรายการเป้าหมายของ Nunes และ Weinstein นำเสนอคำที่แตกต่างกันอย่างสิ้นเชิงในการทดลองที่ 1 และ 2 ของพวกเขา ซึ่งทำให้เกิดความยุ่งยากในการสรุปผลจากการเปรียบเทียบข้ามการทดลองนี้
การศึกษาในปัจจุบัน
ในการทดลองที่ 1 และ 2 ของเรา เราจัดการ PI และแทรกแซงงานในการออกแบบแฟคทอเรียลระหว่างวิชา (ดูรูปที่ 1) โดยเฉพาะอย่างยิ่ง PI ถูกควบคุมโดยการนำเสนอคำจากหมวดหมู่เดียวกันในรายการ (PI สูง) หรือภายในรายการ (LowPI) และงานแทรกแซงถูกจัดการโดยให้ผู้เข้าร่วมทดสอบแบบสอดแทรกหรือช่วงพักฟื้นที่แก้ไขหลังจากแต่ละรายการที่ไม่ใช่เป้าหมาย ผู้เข้าร่วมทั้งหมดทำการทดสอบในรายการเป้าหมายขั้นสุดท้าย ในเงื่อนไข High-PI ผู้เข้าร่วมศึกษารายการแบบผสมที่ประกอบด้วยคำจากหลายประเภท โดยมีคำต่างๆ จากประเภทเดียวกันปรากฏในทุกรายการ จึงเป็นโอกาสสำหรับ PI ในการรวบรวม ในเงื่อนไข Low-PI ผู้เข้าร่วมศึกษารายการที่ถูกบล็อกซึ่งมีคำจากหมวดหมู่เฉพาะสำหรับรายการ 1-4 และการเปลี่ยนแปลงในหมวดหมู่ในรายการต่างๆ ได้รับการออกแบบมาเพื่อปลดปล่อย PI ที่สะสมไว้ หากผลการทดสอบไปข้างหน้าเกิดขึ้นเนื่องจากการทดสอบป้องกันการก่อตัวของสัญญาณรบกวนเชิงรุก เราควรสังเกตผลการทดสอบไปข้างหน้าที่น้อยกว่าในสภาวะ Low-PI มากกว่าในสภาวะ High-PI จากข้อมูลของการทดลองที่ 2 (2012) ของ Nunes และ Weinstein เราอาจคาดหวังว่าผลการทดสอบไปข้างหน้าจะถูกกำจัดในสภาวะ Low-PI เนื่องจากการเปลี่ยนแปลงเนื้อหาควรลบล้างข้อได้เปรียบในการลด PI ของการทดสอบแบบสอดแทรก ในการดูตัวอย่าง ตรงกันข้ามกับการคาดคะเนนี้ เราพบผลการทดสอบไปข้างหน้าที่มีประสิทธิภาพทั้งในสภาวะ High-PI และ Low-PI และขนาดของผลกระทบไม่ได้รับผลกระทบจากการปรับค่า PI ดังนั้นเราจึงตั้งเป้าที่จะจำลองการทดลองที่ 2 ของ Nunes และ Weinstein โดยตรงในการทดลองที่ 3 และ 4 ของเรา
การทดลองที่ 1
วิธี
การออกแบบและผู้เข้าร่วม
ผู้เข้าร่วมเป็นนักศึกษาระดับปริญญาตรี 119 คนจาก Iowa State University ที่เสร็จสิ้นการทดลองสำหรับหน่วยกิตของหลักสูตร มีผู้เข้าร่วม 29 คนใน High-PI เงื่อนไขการทดสอบ 30 คนใน High-PI เงื่อนไข Restudy 32 คนใน LowPI เงื่อนไขการทดสอบ และ 30 คนใน Low-PI เงื่อนไข Restudy ข้อมูลจากผู้เข้าร่วม 14 คนไม่ได้รับการวิเคราะห์เนื่องจากสามคน (เช่น คนหนึ่งอยู่ในเงื่อนไข High-PI, Test; สองคนใน Low-PI, เงื่อนไข Restudy) ไม่ปฏิบัติตามคำแนะนำ และข้อผิดพลาดในการเขียนโปรแกรมทำให้ข้อมูลของผู้เข้าร่วม 11 คนใช้ไม่ได้ (เช่น , หกใน Low-PI, สภาวะทดสอบ, ห้าใน Low-PI, สภาวะ Restudy) ตัวอย่างสุดท้ายรวมข้อมูลจากผู้เข้าร่วม 107 คน โดย 28 คนอยู่ในสภาวะทดสอบ High-PI, 30 คนในสภาวะ High-PI, สภาวะพักการศึกษา, 26 คนอยู่ในสภาวะที่มี PI ต่ำ, สภาวะทดสอบ และ 23 คนอยู่ในสภาวะที่มี PI ต่ำ, สภาวะพักการศึกษา . เราทำการวิเคราะห์กำลังความไวโดยใช้ G*Power (Faul et al., 2007) เพื่อคำนวณขนาดเอฟเฟกต์ที่สามารถตรวจจับได้ตามขนาดตัวอย่างที่เรารวบรวม เราใช้เงื่อนไข Low-PI (รวม n=49) สำหรับการวิเคราะห์นี้ เนื่องจากเงื่อนไขนี้มีผู้เข้าร่วมน้อยกว่าเงื่อนไข High-PI ขนาดเอฟเฟกต์ต่ำสุดที่สามารถตรวจจับได้ด้วยกำลัง .80 คือ d=0.82 ซึ่งเทียบได้กับขนาดเอฟเฟกต์การวิเคราะห์เมตา (d=0.75, Chan, Meissner, et al., 2561). อย่างที่เห็นได้ชัด พลังทางสถิติที่ไม่เพียงพอไม่เคยเป็นปัญหาในการทดลองของเรา เนื่องจากขนาดเอฟเฟกต์ที่สังเกตได้ของเราจะเกินขนาดเอฟเฟกต์ขั้นต่ำที่ตรวจจับได้เสมอ (ที่กำลัง .80) โดยไม่คำนึงว่าผู้เข้าร่วมจะอยู่ในสภาพ PI สูงหรือต่ำ
วัสดุและขั้นตอน
สำหรับการทดลองที่ 1 และ 2 เราเลือกที่จะใช้วัสดุที่คล้ายคลึงกับการศึกษาส่วนใหญ่ที่แสดงผลการทดสอบไปข้างหน้า ด้วยเหตุนี้ เราจึงเลือกคำจากสี่หมวดหมู่ (เช่น ผลไม้ สัตว์ ส่วนต่างๆ ของร่างกาย และกีฬา) ซึ่งแต่ละคำมีตัวอย่างอย่างน้อย 20 คำในบรรทัดฐานของ Van Overschelde, Rawson และ Dunlosky (2004) การให้คะแนนลักษณะทั่วไปโดยเฉลี่ยไม่แตกต่างกันในแต่ละหมวดหมู่ (Mfruits=.18, Manimals=.18, Mbodyparts=.18, Msports=.18), F(3 , 76)=0.01, p=.999, B01=14.45.
ผู้เข้าร่วมศึกษารายการคำ 16-ห้ารายการ ในเงื่อนไข High-PI แต่ละรายการมีสี่ตัวอย่างจากแต่ละหมวดหมู่จากสี่หมวดหมู่ การให้คะแนนลักษณะทั่วไปโดยเฉลี่ยไม่แตกต่างกันในแต่ละรายการ (ช่วง=.17 – .18), F(4, 75)=0.01, p=.999, B{{11 }}.44. คำทั้งหมดในรายการถูกนำเสนอตามลำดับสุ่มหลอก โดยที่รายการจากหมวดหมู่เดียวกันไม่เคยแสดงติดต่อกัน ในเงื่อนไข Low-PI แต่ละรายการจากสี่รายการแรกมีคำจากหมวดหมู่เดียวที่แสดงในลำดับแบบสุ่ม (เช่น รายการที่ 1 อาจมีเฉพาะผลไม้ รายการที่ 2 อาจมีเฉพาะสัตว์) สิ่งสำคัญที่สุดคือ รายการที่ 5 นั้นเหมือนกันสำหรับผู้เข้าร่วมทั้งในเงื่อนไข Low-PI และ High-PI และมีคำศัพท์ใหม่สี่คำจากแต่ละหมวดที่ศึกษาสี่หมวด ดังนั้น PI จึงถูกควบคุมโดยโครงสร้างของรายการ 1–4 ดูที่ด้านบนของภาคผนวก A สำหรับชุดของวัสดุทั้งหมด
ผู้เข้าร่วมกลุ่มไม่เกินแปดคนทำการทดลองโดยใช้คอมพิวเตอร์คั่นด้วยตัวแบ่ง ผู้เข้าร่วมได้รับแจ้งว่าพวกเขาจะศึกษาหลายรายการจาก 16 คำ โดยแต่ละคำจะแสดงสองครั้ง พวกเขายังบอกด้วยว่าหลังจากศึกษาแต่ละรายการแล้ว พวกเขาจะแก้ปัญหาทางคณิตศาสตร์บางอย่าง จากนั้นพวกเขาจะถูกขอให้จำรายการที่เพิ่งนำเสนอหรือให้ศึกษารายการอีกครั้ง ผู้เข้าร่วมได้รับแจ้งว่าคอมพิวเตอร์สุ่มกำหนดว่าจะให้การทดสอบตามแต่ละรายการหรือไม่ ดังนั้นพวกเขาอาจถูก "ขอให้จำคำศัพท์หลังจากทุกรายการ หลังจากเพียงหนึ่งหรือสองรายการ หรือไม่เคยเลย" ในความเป็นจริง ผู้เข้าร่วมได้รับการทดสอบสำหรับทุกรายการ (เงื่อนไขการทดสอบ) หรือได้รับการทดสอบเฉพาะในรายการที่ 5 (เงื่อนไขการศึกษาใหม่) เพื่อให้แน่ใจว่าผู้เข้าร่วมจะศึกษาแต่ละรายการอย่างตั้งใจ พวกเขาได้รับแจ้งเพิ่มเติมว่ามีการทดสอบการเรียกคืนแบบสะสมสำหรับรายการทั้งหมดโดยไม่คำนึงว่าพวกเขาได้รับการทดสอบจำนวนเท่าใด
ที่จุดเริ่มต้นของแต่ละรายการ ข้อความ 2- จะแจ้งให้ผู้เข้าร่วมทราบถึงหมายเลขรายการ (เช่น "นี่คือรายการคำศัพท์ 1") ซึ่งตามด้วยเครื่องหมายกากบาท 1- ต่อไป คำต่างๆ ถูกนำเสนอทีละ 4 วินาทีโดยมีช่วงระหว่างการกระตุ้น 500-ms แต่ละรายการถูกนำเสนอสองครั้งโดยไม่มีการหยุดพัก และลำดับการนำเสนอที่สองแตกต่างจากรายการแรก การกำหนดคำในรายการได้รับการถ่วงดุลระหว่างผู้เข้าร่วม หลังจากศึกษาแต่ละรายการ ผู้เข้าร่วมทำโจทย์เกี่ยวกับพีชคณิตสิบข้อในเวลา 6 วินาทีต่อข้อเพื่อล้างความจำระยะสั้น จากนั้นจึงได้รับการเตือนให้เรียกคืนหรือกลับไปศึกษาใหม่ ผู้เข้าร่วมในเงื่อนไขการทดสอบมีเวลา 60 วินาทีในการจำคำศัพท์จากรายการล่าสุด ในขณะที่ผู้ที่อยู่ในสภาพการศึกษาซ้ำจะเห็นคำเดิมอีกครั้งแต่อยู่ในลำดับสุ่มใหม่ ผู้เข้าร่วมทุกคนมีเวลา 60 วินาทีในการจำคำศัพท์จากรายการที่ 5 จะพบผลการทดสอบไปข้างหน้าหากผู้เข้าร่วมในสภาพการทดสอบจำคำศัพท์จากรายการที่ 5 ได้มากกว่าผู้เข้าร่วมในสภาพที่เหลือ ผู้เข้าร่วมทำภารกิจช่วงการอ่าน (Conway et al., 2005) เสร็จเป็นกิจกรรมเสริมเป็นเวลา 20 นาที จากนั้นจึงทำแบบทดสอบการเรียกคืนแบบสะสมในรายการที่ 1-5 รวม RSPAN และงานการเรียกคืนแบบสะสมเพื่อให้แน่ใจว่าการทดลองใช้เวลาประมาณ 40 นาทีสำหรับวัตถุประสงค์การให้เครดิตหลักสูตรและไม่ได้คะแนน สุดท้าย ผู้เข้าร่วมทำแบบสำรวจสั้น ๆ เกี่ยวกับข้อมูลประชากรและได้รับการซักถาม
ตารางที่ 1 ประสิทธิภาพการทดสอบแบบสอดแทรกที่ไม่ใช่เป้าหมายในการทดลองที่ 1–4
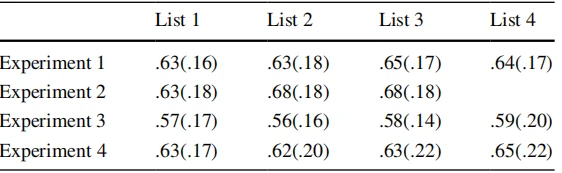
บันทึก. ส่วนเบี่ยงเบนมาตรฐานอยู่ในวงเล็บ
ผลลัพธ์
เพื่อความสมบูรณ์ สัดส่วนของการเรียกคืนที่ถูกต้องสำหรับรายการที่ไม่ใช่เป้าหมายมีการรายงานไว้ในตารางที่ 1 แต่เป้าหมายของการวิจัยของเราเน้นไปที่การเรียกคืนรายการเป้าหมาย สำหรับการทดลองทั้งหมด ขั้นแรกเราจะรายงานความถี่ของการบุกรุกระหว่างการเรียกคืนรายการเป้าหมาย ซึ่งให้การวัดค่า PI เรานิยามการบุกรุกเป็นการเรียกคืนคำจากรายการที่ไม่ใช่เป้าหมาย ไม่พิจารณาการบุกรุกจากภายนอกเนื่องจากไม่ได้แสดงถึงการรบกวนเชิงรุกจากการเรียนรู้รายการก่อนหน้า หากการจัดการ PI สำเร็จ ควรมีการบุกรุกในสภาวะ Low-PI น้อยกว่าในสภาวะ High-PI
ในการทดลองทั้งหมด ผู้เข้าร่วมที่มีการบุกรุกมากกว่า 2 SD จากค่าเฉลี่ยถือว่าผิดปกติ เนื่องจากเราได้บอกผู้เข้าร่วมอย่างชัดเจนให้จำคำศัพท์จากรายการล่าสุดเท่านั้น ผู้ที่กระทำการบุกรุกจำนวนมากอาจไม่ปฏิบัติตามคำแนะนำ ตัวอย่างเช่น หากผู้เข้าร่วมจำคำศัพท์เกี่ยวกับธรรมชาติแปดคำได้ทันทีหลังจากศึกษารายชื่อสัตว์ เราคิดว่าเป็นไปได้ว่าผู้เข้าร่วมรายนี้ไม่ปฏิบัติตามคำแนะนำ เพื่อให้ครอบคลุม เราได้ทำการวิเคราะห์ทั้งหมดโดยมีและไม่มีค่าผิดปกติ เรารายงานผลลัพธ์โดยไม่มีค่าผิดปกติเป็นค่าเริ่มต้น แต่ยังเน้นเมื่อการรวมค่าผิดปกตินำไปสู่ข้อสรุปที่แตกต่างกัน (เพื่อดูตัวอย่าง การวิเคราะห์เพียงครั้งเดียวในการทดลองที่ 3 ให้ผลลัพธ์ที่แตกต่างกัน) นอกจากนี้ ชุดข้อมูลทั้งหมดอยู่ใน Open Science Framework ที่ https://osf.io/wghbc/ และ Figs S2 และ S3 ของ OSM นำเสนอผลลัพธ์รวมถึงค่าผิดปกติ ไม่มีการลงทะเบียนการทดลองล่วงหน้า
หลังจากรายงานข้อมูลการบุกรุก เราจะรายงานการเรียกคืนรายการเป้าหมายที่ถูกต้อง เราตรวจสอบว่าระดับ PI ส่งผลต่อขนาดของผลการทดสอบไปข้างหน้าหรือไม่ หาก PI ที่ลดลงมีบทบาทเชิงสาเหตุ เราควรสังเกตผลการทดสอบไปข้างหน้าที่น้อยกว่าในสภาวะ Low-PI มากกว่าในสภาวะ High-PI เรายังตรวจสอบความสัมพันธ์ระหว่างการบุกรุกและการเรียกคืนที่ถูกต้องในรายการเป้าหมาย เราคาดว่าตัวแปรทั้งสองควรสัมพันธ์กันในทางลบ ดังนั้นผู้เข้าร่วมที่มีการบุกรุกน้อยกว่าควรแสดงการเรียกคืนที่ถูกต้องมากกว่า อย่างไรก็ตาม โปรดทราบว่าความสัมพันธ์นี้ไม่ได้หมายความถึงสาเหตุ
สำหรับการอนุมานทางสถิติ เราใช้การทดสอบแบบสองด้านด้วย ⍺=.05 เรายังรายงานปัจจัยเบส์ เมื่อผลลัพธ์มีนัยสำคัญ เราจะรายงาน B10 ซึ่งบ่งชี้ถึงการสนับสนุนสมมติฐานทางเลือก เมื่อผลลัพธ์ไม่มีนัยสำคัญ เราจะรายงาน B01 ซึ่งบ่งชี้การสนับสนุนสมมติฐานว่าง เราใช้แนวทางนี้เพื่อให้ปัจจัย Bayes ที่มีขนาดใหญ่กว่าบ่งชี้ถึงการสนับสนุนที่มากขึ้นสำหรับเอฟเฟกต์ (ค่าว่างหรืออื่นๆ) ภายใต้การพิจารณา การวิเคราะห์แบบเบย์ทั้งหมดดำเนินการโดยใช้ค่าเริ่มต้น (ทีม JASP, 2020)
การบุกรุกระหว่างการเรียกคืนรายการที่ 5
ในตัวอย่างทั้งหมด ความถี่เฉลี่ยของการบุกรุกคือ 1.03 และส่วนเบี่ยงเบนมาตรฐานคือ 1.84 ดังนั้น ข้อมูลจากผู้เข้าร่วม 5 รายที่กระทำการบุกรุกมากกว่า 4.71 ครั้ง (เช่น 1.03 บวก 2*1.84=4.71) ถือว่าผิดปกติและไม่รวมอยู่ในการวิเคราะห์ แผงด้านซ้ายของรูปที่ 2 แสดงข้อมูลการบุกรุก เราดำเนินการ 2 (งานแทรกแซง: ทดสอบเทียบกับส่วนที่เหลือ) × 2 (ระดับ PI: สูงและต่ำ) ANOVA โดยมีความถี่ของการบุกรุกระหว่างการเรียกคืนรายการที่ 5 เป็นตัวแปรตาม มีผลกระทบหลักของงานแทรกแซง F(1,98)=34.84, p < .001, d=1.14, B10=108753.94 ซึ่งทำให้ ผู้เข้าร่วมการศึกษา (M=1.31) ทำการบุกรุกมากกว่าผู้เข้าร่วมการทดสอบ (M=0.19) ไม่น่าแปลกใจที่การดึงข้อมูลที่สอดแทรกจะช่วยลดการบุกรุก เนื่องจากผลกระทบดังกล่าวแสดงให้เห็นอย่างกว้างขวาง (Chan, Manley, et al., 2018; Szpunar et al., 2008; Weinstein et al., 2011) สิ่งที่สำคัญกว่าสำหรับจุดประสงค์ปัจจุบัน ผลกระทบหลักของระดับ PI นั้นมีนัยสำคัญ F(1,98)=12.27, p=.002, d=0.59, B{ {40}}.36 โดยผู้เข้าร่วมในเงื่อนไข High-PI (M=1.02) กระทำการบุกรุกเกือบสามเท่าเมื่อเทียบกับผู้เข้าร่วมในเงื่อนไข Low-PI (M=0.38) ซึ่งแสดงว่าการจัดการ PI ของเราประสบความสำเร็จ

รูปที่ 2 ความถี่ของการบุกรุกระหว่างการเรียกคืนตามรายการที่ 5 (ซ้าย) และสัดส่วนของการเรียกคืนที่ถูกต้องตามรายการที่ 5 (ขวา) เป็นฟังก์ชันของงานแทรกแซงและระดับ PI ในการทดลองที่ 1 แถบแสดงข้อผิดพลาดแสดงช่วง .95 confence ที่อธิบายได้ แต่ละจุดแสดงข้อมูลจากผู้เข้าร่วมแต่ละคน Jitter ถูกนำมาใช้เพื่อกระจายจุดข้อมูลในแนวนอนเพื่อเพิ่มการมองเห็น
ปฏิสัมพันธ์ระหว่างงานแทรกแซงและระดับ PI ก็มีความสำคัญเช่นกัน F(1,98)=5.61, p=.020, ηp 2=.04, B{{8} }.73. โดยเฉพาะอย่างยิ่ง ผู้เข้าร่วมการทดสอบสร้างการบุกรุกน้อยที่สุดโดยไม่คำนึงถึงระดับ PI (MHigh-PI=0.29 เทียบกับ MLow-PI=0.08), t(52)=1.50, p=.139, d=0.41, B01=1.45 แต่ผู้เข้าร่วมการศึกษาที่เหลือสร้างการบุกรุกน้อยลงอย่างมากหากอยู่ในสภาวะ Low-PI มากกว่าในสภาวะ HighPI (MHigh -PI=1.81 เทียบกับ MLow-PI=0.73), t(46)=3.02, p=.004, d=0 .87, บ01=9.70.
รายการ 5 การเรียกคืนที่ถูกต้อง
แผงด้านขวาของรูปที่ 2 แสดงข้อมูลการเรียกคืนที่ถูกต้องตามรายการที่ 5 การวิเคราะห์ความแปรปรวนแบบ 2 × 2 เดียวกันแสดงให้เห็นผลกระทบหลักสำหรับงานแทรกแซง F(1,98)=15.95, p < .001, d=0.81, B{{ 11}}.75 ซึ่งแสดงผลการทดสอบล่วงหน้าโดยรวม (Mtest=.51 เทียบกับ Mrestudy=.34) การจัดการ PI ไม่ส่งผลต่อการเรียกคืนที่ถูกต้อง (MHigh-PI=.43 เทียบกับ MLow-PI=.44), F(1,98)=0.05, p {{27 }} .826, d=0.05, B01=4.64. สิ่งที่น่าสนใจยิ่งกว่าคือ ผลกระทบจากการโต้ตอบก็ไม่มีนัยสำคัญเช่นกัน F(1,98)=0.78, p=.379, ηp 2=.01, B01=2 .95. ตรงกันข้ามกับความคาดหมายที่ว่าการลด PI จะลดขนาดของผลการทดสอบล่วงหน้าด้วย กลุ่มทดสอบมีประสิทธิภาพดีกว่ากลุ่มที่เหลืออย่างมากทั้งในสภาวะที่มี PI ต่ำ (Mtest=.50 เทียบกับ Mrestudy=.36), t(46)=2.78, p=.008, d=0.81, B10=5.88 และเงื่อนไข HighPI (Mtest { {57}} .52 เทียบกับ Mrestudy=.32), t(52)=3.00, p < .001, d=0.82, B10=9 .76. ขนาดของเอฟเฟ็กต์การทดสอบไปข้างหน้า (เช่น ขนาดเอฟเฟ็กต์) เกือบจะเท่ากันโดยไม่คำนึงถึงเงื่อนไขของ PI ผลการทดสอบไปข้างหน้าที่มีประสิทธิภาพในสภาวะ Low-PI ขัดแย้งกับข้อมูล Experiment 2 ของ Nunes และ Weinstein อย่างชัดเจน แม้ว่าการจัดการ PI จะไม่ส่งผลกระทบต่อผลการทดสอบล่วงหน้า ตามที่คาดการณ์ไว้โดยบัญชีที่เผยแพร่จาก PI แต่เราสังเกตเห็นความสัมพันธ์เชิงลบอย่างมากระหว่างการบุกรุกและการเรียกคืนที่ถูกต้อง r(100)=-.45, p < .001, B10=8154.72 ดังนั้นบุคคลที่จำรายการที่ถูกต้องได้มากกว่าจึงเกิดการบุกรุกน้อยลง (ดูรูปที่ 3) การตรวจสอบอย่างใกล้ชิดพบว่าความสัมพันธ์นี้ขับเคลื่อนโดยผู้เข้าร่วมในสภาพการศึกษาใหม่ r(46)=-.45, p < .001, B10=25.82 เนื่องจากผู้เข้าร่วมในสภาวะการทดสอบมี การบุกรุกในระดับใกล้พื้น จึงจำกัดช่วงคะแนนของตัวแปรนี้ และลดโอกาสในการค้นหาความสัมพันธ์ใดๆ r(52)=-.15, p=.284, B{{92 }}.37.
การอภิปราย
จุดประสงค์ของการทดลองที่ 1 คือเพื่อตรวจสอบว่าขนาดของผลการทดสอบไปข้างหน้านั้นไวต่อความแตกต่างในการอนุมานเชิงรุกหรือไม่ ตามที่คาดไว้ ผู้เข้าร่วมในสภาวะ High-PI ทำให้เกิดการบุกรุกมากกว่าผู้เข้าร่วมที่มี PI ต่ำ นอกจากนี้ ผลกระทบของ PI ยังบรรเทาได้ด้วยการทดสอบแบบสอดแทรก สรุปแล้ว ข้อมูลการบุกรุกตรวจสอบการจัดการ PI ของเรา แม้จะมีผลลัพธ์เหล่านี้ สัดส่วนของการเรียกคืนที่ถูกต้องหรือขนาดของผลการทดสอบไปข้างหน้าไม่ได้รับอิทธิพลจากการจัดการ PI ซึ่งแสดงให้เห็นว่าการปลดปล่อยจากการรบกวนเชิงรุกอาจเป็นปัจจัยร่วมของผลการทดสอบไปข้างหน้ามากกว่าสาเหตุของ ผลลัพธ์ที่น่าสนใจเพิ่มเติมคือความสัมพันธ์เชิงลบที่แข็งแกร่งระหว่างการเรียกคืนที่ถูกต้องและการบุกรุก แม้ว่า PI จะได้รับผลกระทบจาก PI ก็ตาม มูลค่าที่ตราไว้ ความสัมพันธ์นี้สอดคล้องกับบัญชีที่ปล่อยจาก PI เนื่องจากผู้เข้าร่วมที่มีประสบการณ์น้อยกว่า PI จะแสดงการเรียกคืนที่ถูกต้องมากกว่า ดังนั้นการทดสอบอาจปรับปรุงการเรียนรู้ใหม่เนื่องจากช่วยลดการสะสมของ PI เราพิจารณาความหมายของความสัมพันธ์นี้อย่างครบถ้วนมากขึ้นในการอภิปรายทั่วไป แต่พอจะกล่าวได้ว่าข้อมูลของเราบ่งชี้ว่าความสัมพันธ์เชิงลบระหว่างการเรียกคืนที่ถูกต้องและการบุกรุกไม่ได้หมายความถึงสาเหตุ แต่การจับคู่ของตัวแปรเหล่านี้อาจขับเคลื่อนโดยตัวแปรที่สาม เช่น ความสนใจที่เพิ่มขึ้นหรือการจัดระเบียบหน่วยความจำที่เพิ่มขึ้นเนื่องจากการทดสอบ (Chan et al., 2020)
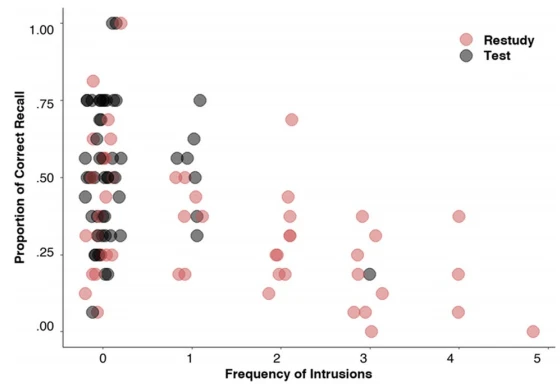
รูปที่ 3 แผนภูมิกระจายที่แสดงความสัมพันธ์ระหว่างความถี่ของการบุกรุกระหว่างการเรียกคืนตามรายการที่ 5 และสัดส่วนของการเรียกคืนที่ถูกต้องตามรายการที่ 5 ในการทดลองที่ 1 ในแต่ละกรณี ความถี่ของการบุกรุกจะเป็นจำนวนเต็มเสมอ ดังนั้นจึงมีข้อมูลที่ทับซ้อนกันอย่างมาก คะแนน เพื่อปรับปรุงการมองเห็นความหนาแน่นของข้อมูล เราแนะนำ Jitter เพื่อกระจายจุดข้อมูลในแนวนอน
แม้ว่าข้อมูลในการทดลองที่ 1 แสดงให้เห็นว่าการลดลงของ PI อาจไม่ได้มีบทบาทเชิงสาเหตุในผลการทดสอบไปข้างหน้า แต่ก็ยังเป็นไปได้ที่เราสังเกตเห็นผลการทดสอบไปข้างหน้าในสภาวะ Low-PI เนื่องจากการจัดการ PI ของเราอ่อนแอเกินไป โดยเฉพาะอย่างยิ่ง ผู้เข้าร่วมในเงื่อนไข Low-PI, Restudy อาจยังคงประสบกับ PI ที่สูงกว่าคู่ที่ทดสอบอยู่มาก เนื่องจากรายการที่ 5 มีคำจากหมวดหมู่ที่ปรากฏในรายการที่ 1-4 ความเป็นไปได้นี้สามารถตรวจสอบได้โดยการเปรียบเทียบข้อมูลการบุกรุกระหว่างผู้เข้าร่วมการทดสอบและผู้เข้าร่วมการศึกษาที่เหลือในเงื่อนไข LowPI แม้ในขณะที่ตั้งใจให้ PI ต่ำ ผู้เข้าร่วมการทดสอบ (M=0.08) ทำการบุกรุกน้อยกว่าผู้เข้าร่วมการศึกษาที่เหลือ (M=0.73), t(46)=3 .10, หน้า=.003, ง=0.90, บ10=11.58 การค้นพบนี้แสดงให้เห็นว่าการจัดการของเราไม่ได้ทำให้พลังของการทดสอบที่ลดลงของ PI นั้นไม่เกี่ยวข้อง ซึ่งอาจอธิบายได้ว่าทำไมเราจึงพบผลการทดสอบไปข้างหน้าในสภาวะที่มี PI ต่ำ
ในการทดลองที่ 2 เรามีเป้าหมายที่จะลด PI ลงอีกสำหรับผู้เข้าร่วมในสภาวะ PI ต่ำ ด้วยเหตุนี้ ทุกรายการรวมถึงรายการเป้าหมายจึงรวมเฉพาะคำจากหมวดหมู่เดียว เหตุผลคือเพื่อลดอิทธิพลของ PI ต่อการเรียนรู้และการเรียกคืนรายการเป้าหมายโดยขจัดความเป็นไปได้ที่คำในรายการเป้าหมายจะเตือนผู้เข้าร่วมถึงรายการที่ศึกษาก่อนหน้านี้
การทดลองที่ 2
วิธี
การออกแบบและผู้เข้าร่วม
ระดับ PI (สูงและต่ำ) และงานแทรกแซง (การทดสอบเทียบกับส่วนที่เหลือ) ถูกจัดการระหว่างวิชา ผู้เข้าร่วมเป็นนักศึกษาระดับปริญญาตรี 120 คนจาก Iowa State University ที่เข้าร่วมในหน่วยกิตของหลักสูตร ข้อมูลจากผู้เข้าร่วม 5 คนไม่ได้รับการวิเคราะห์ เนื่องจาก 3 คนไม่ปฏิบัติตามคำแนะนำ และอีก 2 คนเกี่ยวข้องกับข้อผิดพลาดของคอมพิวเตอร์ ตัวอย่างสุดท้ายจึงรวมข้อมูลจากผู้เข้าร่วม 115 คน โดย 31 คนอยู่ในสภาวะ High-PI สภาวะการพักฟื้น 28 คนในสภาวะที่มี PI สูง สภาวะการทดสอบ 28 คนในสภาพที่มี PI ต่ำ สภาวะการทดสอบ และ 28 คนในสภาวะที่มี PI ต่ำ การพักฟื้น เงื่อนไข. สำหรับการวิเคราะห์พลังงานความไว เราใช้ขนาดตัวอย่างของเงื่อนไข Low-PI ซึ่งมีผู้เข้าร่วมน้อยกว่า การวิเคราะห์แสดงให้เห็นว่าเราสามารถตรวจพบขนาดเอฟเฟกต์ที่ d=.76 ด้วยกำลัง .80
วัสดุและขั้นตอน
ขั้นตอนของการทดลองที่ 2 เหมือนกับการทดลองที่ 1 โดยมีข้อยกเว้นดังต่อไปนี้ ประการแรก ในเงื่อนไข High-PI คำสามคำจากแต่ละหมวดหมู่จะกระจายอยู่ในสี่รายการ ดังนั้นแต่ละรายการจึงมีคำจากสี่หมวดหมู่เดียวกัน ในเงื่อนไข Low-PI ทุกรายการ รวมถึงรายการเป้าหมาย จะมีคำจากหมวดหมู่เดียว โปรดทราบว่าผู้เข้าร่วมทั้งหมดศึกษาคำเดียวกันจากสี่หมวดหมู่ โดยความแตกต่างเพียงอย่างเดียวในเงื่อนไขคือลำดับการนำเสนอของคำในรายการ เนื้อหาทั้งหมดนำเสนอในภาคผนวก A ประการที่สอง มีการใช้คำจากหมวดหมู่ของผลไม้ สัตว์ ส่วนต่างๆ ของร่างกาย และเครื่องเรือน และมีการให้คะแนนลักษณะทั่วไปโดยเฉลี่ยเท่ากัน (Mfruits=.18, Manimals { {6}} .18, ชิ้นส่วนตัวถัง=.18, เฟอร์นิเจอร์=.18), F(3, 60)=0.00, p=1 .00, บ01=11.71. สุดท้าย ผู้เข้าร่วมศึกษาสี่รายการ 16 คำแต่ละรายการแทนที่จะเป็นห้ารายการ การทดลองที่ 1 ดำเนินการหลังจากรอบลำดับเหตุการณ์ของการทดลองที่ 2 แต่การศึกษาได้นำเสนอในลำดับปัจจุบันเพื่อจุดประสงค์ในการอธิบาย ตรรกะคือการนำเสนอการศึกษาด้วยการจัดการ PI ที่อ่อนแอกว่า (เช่น การทดลองที่ 1) ก่อน จากนั้นจึงนำเสนอการศึกษาด้วยการจัดการ PI ที่เข้มข้นกว่า (เช่น การทดลองที่ 2) จำนวนรายการศึกษาและเนื้อหาแตกต่างกันในการทดลองทั้งสองเนื่องจากเราต้องการคำเพิ่มเติมในการทดลองที่ 1 เพื่อสร้างรายการที่ 5 ที่รวมคำหมวดหมู่จากรายการที่ 1-4 ในขณะที่รักษาความยาวของรายการไว้ที่ 16 คำ และ Furniture มีตัวอย่างไม่เพียงพอ เพื่อจุดประสงค์นี้.
ผลลัพธ์
การบุกรุกระหว่างการเรียกคืนรายการที่ 4
จุดตัดที่ผิดปกติสำหรับการทดลองนี้คือ 4.79 การบุกรุก (M=0.85, SD=1.97) และไม่รวมข้อมูลจากผู้เข้าร่วมเจ็ดคน แผงด้านซ้ายของรูปที่ 4 แสดงความถี่ของการบุกรุกระหว่างการเรียกคืนรายการที่ 4 เนื่องจากผู้เข้าร่วมในเงื่อนไขการทดสอบ Low-PI ไม่มีการบุกรุกใดๆ เลย จึงเป็นไปไม่ได้ที่จะทำ ANOVA แบบ 2 (ทดสอบเทียบกับการพัก) × 2 (PI สูงเทียบกับ Low-PI) ดังนั้นเราจึงทำการทดสอบ t ระหว่างเงื่อนไข High- และ Low-PI เพื่อตรวจสอบอิทธิพลของการจัดการ PI ต่ออัตราการบุกรุกโดยรวม ตามที่คาดไว้ ผู้เข้าร่วมในสภาวะ High-PI (M=0.71) สร้างการบุกรุกมากกว่าผู้ที่อยู่ในสภาวะ Low-PI (M=0.11), t(106) {{24} }.46, p < .001, d=0.67, B10=36.67 อันที่จริง ความถี่ของการบุกรุกในสภาวะ Low-PI ไม่แตกต่างจากศูนย์, t(52)=1.43, p=.159, d=0.20, B{ {39}}.57. ข้อเท็จจริงที่ว่าการบุกรุกถูกลบออกเกือบทั้งหมดในสภาวะ Low-PI (M=0.24 สำหรับผู้เข้าร่วมในสภาพที่เหลือ โดยผู้เข้าร่วม 23 คนจาก 25 คนไม่มีการบุกรุก และอีกสองคนที่เหลือทำให้เกิดการบุกรุกแต่ละครั้ง ดู รูปที่ 4) แสดงให้เห็นว่าการจัดการ PI ของเราในการทดลองที่ 2 มีผลตามที่ตั้งใจไว้ สุดท้าย โดยรวมแล้ว ผู้เข้าร่วมการศึกษา (M=0.80) กระทำการบุกรุกมากกว่าผู้เข้าร่วมการทดสอบ (M=0.09), t(106)=4.24, p < 001, d=0.82, B10=425.83.
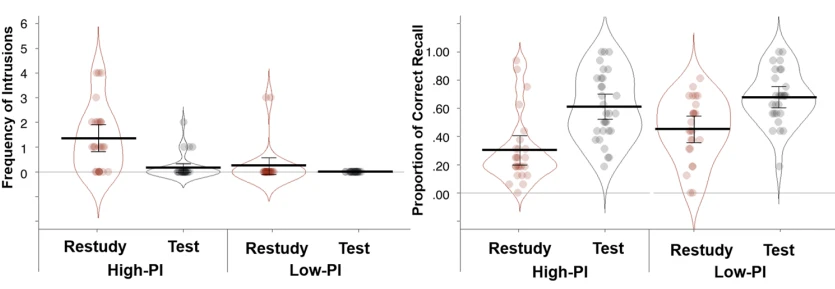
รูปที่ 4 ความถี่ของการบุกรุกระหว่างการเรียกคืนตามรายการที่ 4 (ซ้าย) และสัดส่วนของการเรียกคืนที่ถูกต้องตามรายการที่ 4 (ขวา) เป็นฟังก์ชันของงานแทรกแซงและระดับ PI ในการทดลองที่ 2 แถบแสดงข้อผิดพลาดแสดงช่วงความเชื่อมั่นที่ละเอียด .95 Jitter ถูกนำมาใช้เพื่อกระจายจุดข้อมูลในแนวนอนเพื่อเพิ่มการมองเห็น
รายการ 4 การเรียกคืนที่ถูกต้อง
แผงด้านขวาของรูปที่ 4 แสดงสัดส่วนของการเรียกคืนที่ถูกต้องตามรายการที่ 4 จากความสำเร็จของการจัดการ PI ของเรา เราควรคาดหวังว่าผลการทดสอบล่วงหน้าจะอ่อนแอลงอย่างมาก (และอาจไม่มีเลย) ในสภาวะ Low-PI มากกว่าในสภาวะ High-PI อย่างไรก็ตาม เช่นเดียวกับการทดลองที่ 1 ปฏิสัมพันธ์ระหว่างระดับ PI และกิจกรรมระหว่างกาลนั้นไม่มีนัยสำคัญอีกครั้ง F(1,104)=0.82, p=.367, ηp 2=.01, บ01=2.82. การทำซ้ำผลลัพธ์ของการทดลองที่ 1 การลด PI ไม่ได้ลดผลการทดสอบไปข้างหน้า โดยเฉพาะอย่างยิ่ง ผู้เข้าร่วมการทดสอบมีประสิทธิภาพดีกว่าผู้เข้าร่วมการศึกษาใหม่ทั้งในเงื่อนไข Low-PI (การทดสอบ Mtest=.68, Mrestudy=.45), t(51)=3.98, p < .001, d=1.09, B10=111.69 และสภาวะ High-PI (Mtest=.61, Mrestudy=.30), t(53 )=4.68, p < .001, d=1.20, B10=894.56. ผลการทดสอบไปข้างหน้าอันทรงพลังในสภาวะ Low-PI นั้นโดดเด่นเป็นพิเศษ เนื่องจากผู้เข้าร่วมในสภาวะนี้แทบจะไม่มีการบุกรุกใดๆ เลย แม้ว่าการจัดการ PI ของเราจะมีอิทธิพลเพียงเล็กน้อยต่อผลการทดสอบล่วงหน้า แต่ก็มีความสัมพันธ์เชิงลบอย่างมากอีกครั้งระหว่างการเรียกคืนที่ถูกต้องและการบุกรุก (ดูรูปที่ 5), r(106)=-.44, p < .001, B10=8395.88 และผลกระทบนี้ถูกผลักดันอีกครั้งโดยผู้เข้าร่วมในสภาพการศึกษาใหม่ r(48)=-.41, p=.003, B10=12 06 แทนที่จะเป็นเงื่อนไขการทดสอบ r(56)=-.14, p=.296, B01=3.58
การอภิปราย
ในการทดลองนี้ เราพยายามลด PI เพิ่มเติมสำหรับผู้เข้าร่วมในสภาวะ Low-PI เพื่อจุดประสงค์นี้ เรามีคำศัพท์สำหรับการศึกษากลุ่ม Low-PI จากหมวดหมู่เดียวสำหรับรายการทั้งหมด ซึ่งลดการบุกรุกลงเหลือระดับใกล้สี่สำหรับผู้เข้าร่วมในสภาวะ Low-PI แม้จะมีผลลัพธ์นี้ ผลการทดสอบไปข้างหน้ายังคงแข็งแกร่ง และขนาดของมันไม่ได้รับผลกระทบจากการจัดการ PI
เมื่อนำมารวมกัน ผลการทดลองของเราแตกต่างจากที่รายงานโดย Nunes และ Weinstein (2012) ตามที่ระบุไว้ในบทนำ การรวมกันของการทดลองที่ 1 และ 2 เปรียบได้กับเงื่อนไข HighPI และ Low-PI ของเรา โดยเฉพาะอย่างยิ่ง ผู้เข้าร่วมในการทดลองที่ 1 ศึกษาธีม DRM ต่างๆ ในแต่ละรายการ ซึ่งคล้ายกับเงื่อนไข High-PI ของเรา และในการทดลองที่ 2 ผู้เข้าร่วมศึกษาธีม DRM แต่ละรายการในแต่ละรายการ ซึ่งสอดคล้องกับเงื่อนไข Low-PI ของเรา พบผลการทดสอบไปข้างหน้าในการทดลองที่ 1 แต่ไม่มีผลในการทดลองที่ 2
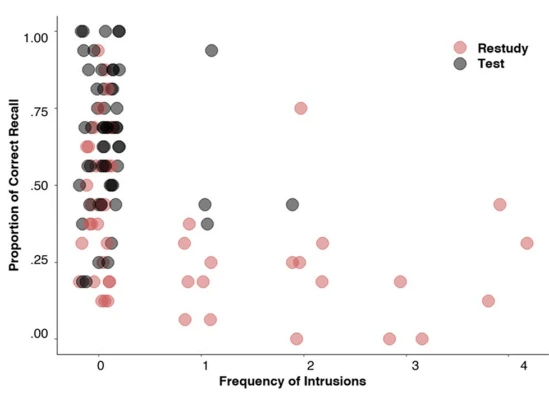
รูปที่ 5 แผนภูมิกระจายที่แสดงความสัมพันธ์ระหว่างความถี่ของการบุกรุกระหว่างการเรียกคืนตามรายการที่ 4 และสัดส่วนของการเรียกคืนที่ถูกต้องตามรายการที่ 4 ในการทดลองที่ 2 เพื่อปรับปรุงการมองเห็นความหนาแน่นของข้อมูล เราแนะนำ jitter เพื่อกระจายจุดข้อมูลในแนวนอน
เหตุใดการศึกษาปัจจุบันและ Nunes and Weinstein (2012) จึงแสดงผลที่ตรงกันข้าม แม้ว่าการออกแบบการทดลองของเราจะจำลองมาจาก Nunes และ Weinstein แต่ความแตกต่างของระเบียบวิธีก็ยังคงมีอยู่หลายประการ บางทีสิ่งที่ชัดเจนที่สุดคือวัสดุ กล่าวคือ เราใช้รายการที่จัดหมวดหมู่ ในขณะที่ Nunes และ Weinstein ใช้รายการ DRM โดยรายการแรกสร้างตามบรรทัดฐานของหมวดหมู่ และรายการหลังสร้างตามบรรทัดฐานที่เชื่อมโยง ความแตกต่างของระเบียบวิธีอีกประการหนึ่งระหว่างการศึกษาคืองานเปรียบเทียบ ในทั้งสองการศึกษา ผู้เข้าร่วมทุกคนทำโจทย์คณิตศาสตร์เสร็จ 1 นาทีหลังจากศึกษาแต่ละรายการคำศัพท์ ต่อไปนี้ ผู้เข้าร่วมในสภาวะควบคุมจะศึกษาคำศัพท์ในการทดลองของเราอีกครั้ง ในขณะที่พวกเขาแก้ปัญหาทางคณิตศาสตร์เพิ่มเติมในการทดลองของ Nunes และ Weinstein
แม้จะมีความแตกต่างของวิธีการเหล่านี้ แต่เราก็ไม่สามารถเข้าใจคำอธิบายที่น่าสนใจซึ่งจะอธิบายถึงผลลัพธ์ที่แตกต่างกันอย่างมากมาย โดยเฉพาะอย่างยิ่ง เป็นการยากที่จะจินตนาการถึงความแตกต่างของระเบียบวิธีเหล่านี้ซึ่งมีผลต่างกันต่อขนาดของผลการทดสอบล่วงหน้า ขึ้นอยู่กับว่าผู้เข้าร่วมคาดว่าจะได้รับค่า PI ที่สูงขึ้นหรือต่ำลง ตามความรู้ของเรา ไม่มีคำอธิบายเชิงทฤษฎีที่มีอยู่ (Chan, Meissner, et al., 2018) ที่จะนำไปสู่การทำนายว่าการจัดการ PI จะส่งผลกระทบต่อผลการทดสอบไปข้างหน้าด้วยคำ DRM ที่เชื่อมโยง แต่ไม่ใช่กับคำที่จัดหมวดหมู่ (หรือกับการใช้ปัญหาทางคณิตศาสตร์เป็น งานควบคุมแต่ไม่มีงานศึกษาเหลือเป็นงานควบคุม) ดังนั้นเราจึงตั้งเป้าที่จะจำลองการทดลองที่ 2 ของ Nunes และ Weinstein โดยตรง